这三道题表面上分别在问传输时间、交换方式比较和最优分组长度,实际上考的是同一条知识链:
数据从一个大文件变成分组,再变成链路上的 bit;分组经过多条链路时,如何计算时延,以及如何在首部开销和流水线效率之间取得平衡。
这篇笔记按照“先讲题目解法,再汇总知识点”的顺序整理。每道题都会把当时最容易混淆的地方单独挑出来,重点解释为什么这样建模,而不是只把公式和答案列出来。
一、题目解法
1. 2010 年题 34:存储-转发与流水线
原题
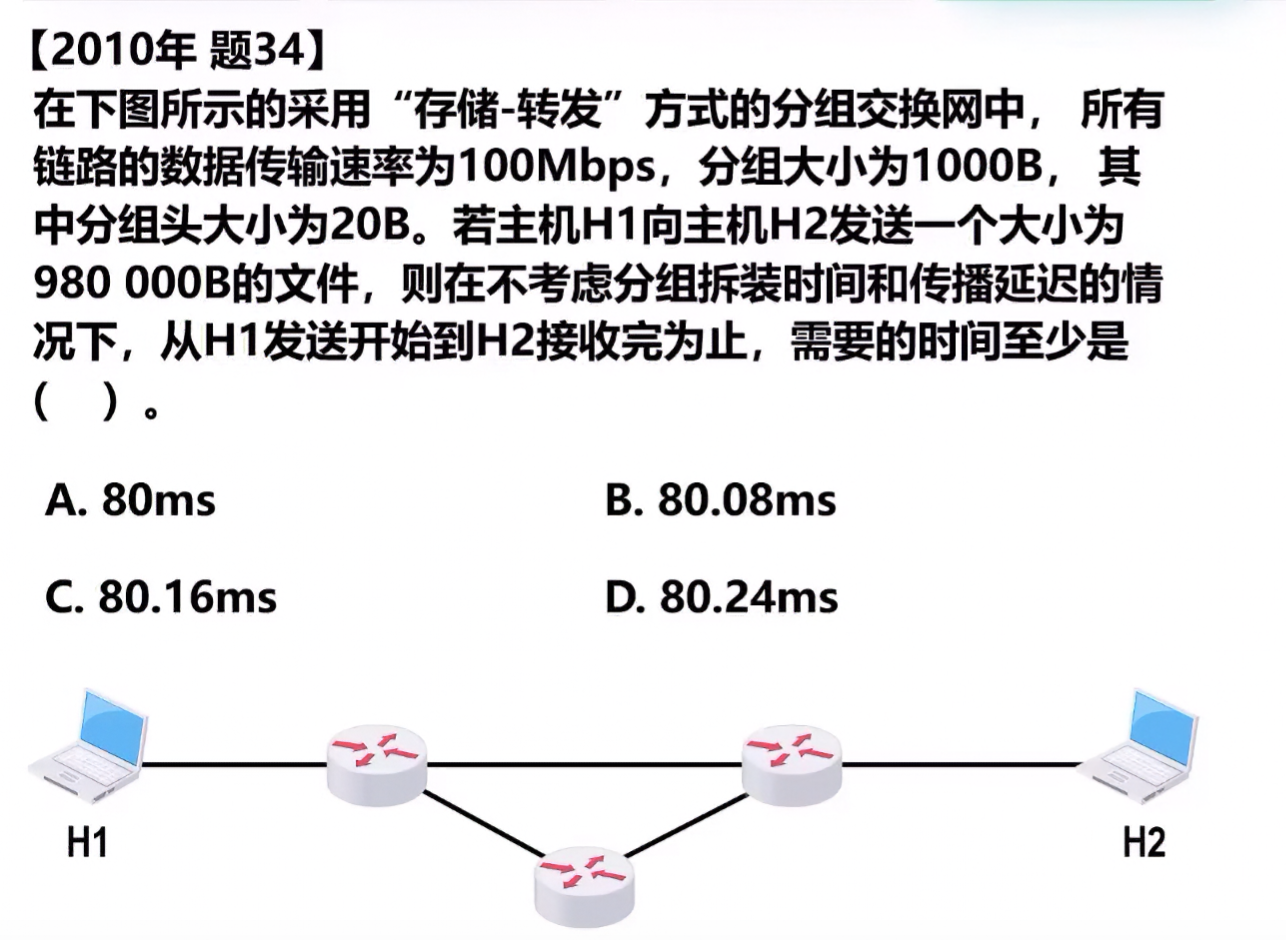
这道题的原题直接保留原图,不再把选择题题面重新抄一遍:
从题目中提取计算所需的条件:
- 文件大小:980000B;
- 一个完整分组大小:1000B;
- 每个分组首部:20B;
- 链路速率:100Mbps;
- 最短路径包含 3 条链路;
- 不考虑分组拆装时间和传播时延。
第一步:求一个分组真正携带的文件数据
一个分组总共有 1000B,但其中 20B 是首部,真正属于文件内容的只有:
1000B - 20B = 980B这里最容易误解的是:题目说的“分组大小”是完整分组的大小,不能把首部从后续的发送时延中丢掉。首部虽然不是文件内容,却同样需要占用链路。
第二步:求分组数量
N = 980000B / 980B = 1000所以文件会被切成 1000 个分组。
这里的 980B 是“每个分组携带的有效数据”,不是分组在链路上的完整长度。两个量要分开记:
- 用 980B 求分组数量;
- 用 1000B 求一个分组的发送时延。
第三步:求一个分组经过一条链路的发送时延
发送时延的公式是:
d_trans = L / R分组大小必须包括首部:
1000B = 8000bit100Mbps = 100 × 10^6bit/s因此:
d_trans = 8000 / (100 × 10^6) s = 0.00008s = 0.08ms第四步:理解存储-转发到底在等什么
存储-转发不是收到第一个 bit 就立刻把它送到下一条链路,而是要先把一个完整分组接收下来,再转发这个完整分组。
也就是说,交换设备等待的是:
分组的最后一个 bit 到达而不是:
- 首部刚到达;
- 第一个 bit 刚到达;
- 整个文件全部到达。
这也是“分组”这个概念必须稳定下来的原因:存储-转发的基本单位是完整分组。
第五步:利用流水线计算总时间
第一个分组要依次经过 3 条链路,所以需要:
3 × 0.08ms但第二个分组不需要等第一个分组到达终点后才开始。第一个分组进入第二条链路时,第二个分组已经可以进入第一条链路;之后不同分组会同时占用不同链路。
可以把过程想成:
链路 1:分组1 分组2 分组3 ……链路 2: 分组1 分组2 ……链路 3: 分组1 ……因此,1000 个分组经过 3 条链路的总时间不是 1000 × 3 × 0.08ms,而是:
T = (N + K - 1) × d_trans = (1000 + 3 - 1) × 0.08ms = 80.16ms答案是:
80.16ms其中 N 是分组数量,K 是链路数量。题目问的是经过几条链路,不是中间有几个交换机。
2. 1-10:电路交换和分组交换比较
题目
设要传送的报文长度为 x bit,从源点到终点共经过 k 条链路,每条链路的传播时延为 d s,链路速率为 b bit/s,电路交换建立连接的时间为 s s。采用分组交换时,分组的数据部分长度为 p bit,且 x > p,忽略各结点的排队等待时间。问:在什么条件下,分组交换的时延比电路交换更小?
下面按题目常见的理想模型,先假设 x 可以被 p 整除。
电路交换的时延
电路交换的过程是:先建立连接,再连续发送完整报文:
T_c = s + x / b + kd其中:
s是建立连接的时间;x / b是把整个报文推出链路的发送时间;kd是经过k条链路的传播时延。
分组交换的时延
分组数量为:
N = x / p每个分组的数据部分长度为 p bit,所以在本题的简化模型中,一个分组的一次发送时延写成 p / b。采用存储-转发并形成流水线后:
T_p = (x / p + k - 1) × p / b + kd展开:
T_p = x / b + (k - 1)p / b + kd比较两种方式
要求分组交换更快:
T_p < T_c代入两式:
x / b + (k - 1)p / b + kd < s + x / b + kd两边都有的 x / b 和 kd 可以抵消,得到:
(k - 1)p / b < s也可以写成:
p < sb / (k - 1)这道题真正容易卡住的地方
第一,为什么 x / b 两边都有?
因为不管采用哪种交换方式,最终都必须把这份报文中的数据发送出去。分组交换虽然拆成了很多分组,但所有分组的数据总量仍然是 x bit,所以公共发送时间仍然是 x / b。
第二,为什么只剩下 (k - 1)p / b?
第一个分组需要沿着额外的链路逐段填充流水线。后续分组可以重叠传输,因此分组交换相对连续发送多出来的不是 k 倍时间,而是 k - 1 个分组发送时延。
第三,为什么传播时延 kd 也能抵消?
因为两种方式都要经过同一条路径,且题目给出的每条链路传播时延相同。真正需要比较的是:电路交换的连接建立时间,和分组交换的流水线填充时间谁更大。
3. 1-11:为什么存在最佳分组长度
题目
在上一题的分组交换网络中,报文长度为 x bit。一个分组的总长度为 (p + h) bit,其中 p 是分组的数据部分,h 是每个分组固定携带的控制信息长度。通信经过 k 条链路,链路速率为 b bit/s,忽略结点排队时间。若希望总时延最小,分组的数据部分长度 p 应取多大?
建立总时延模型
每个分组真正携带 p bit 的报文数据,所以分组数量为:
N = x / p但一个完整分组还要加上 h bit 的首部或控制信息,因此一次发送的完整长度是:
p + h一个分组经过一条链路的发送时延是 (p + h) / b。使用存储-转发流水线后,总时延为:
T = (x / p + k - 1) × (p + h) / b + kd展开:
T = [x + xh / p + (k - 1)p + (k - 1)h] / b + kd和 p 无关的部分可以先看作常数,所以真正需要优化的是:
f(p) = xh / p + (k - 1)p分组太小会怎样
当 p 很小时,同样大小的报文需要切成更多分组,首部也会重复更多次:
xh / p 变大这意味着有效数据比例下降,首部开销占比上升。
分组太大会怎样
当 p 很大时,每个分组的发送时间变长,经过多条链路时,流水线开始阶段需要等待更久:
(k - 1)p 变大所以分组也不是越大越好。
求两种代价的平衡点
对 f(p) 求导:
f'(p) = -xh / p^2 + (k - 1)令导数为 0:
-xh / p^2 + (k - 1) = 0得到:
p^2 = xh / (k - 1)因此最优的数据部分长度为:
p* = √[xh / (k - 1)]这个结果也可以理解成:
xh / p = (k - 1)p左边是分组太小带来的首部开销,右边是分组太大带来的流水线填充开销。最优点就是两种代价达到平衡的位置。
这里得到的是连续取值、忽略 MTU、整数分组数和最后一个不足分组等现实限制时的理论答案。实际网络设计还要在这个理论值的基础上考虑协议上限和分组格式。
二、题目讲完后的知识点汇总
1. 文件、报文、分组、帧和 bit
一个文件不会直接以“整个文件”的形式一次性通过网络。可以先固定下面这张图:
文件 / 报文 ↓ 切分分组 ↓ 封装帧 ↓ 串行发送bit ↓链路- 报文:应用层要发送的完整数据;
- 分组:网络层把报文切成的小块,是分组交换中的基本单位;
- 帧:数据链路层在一条链路上的传输单位;
- bit:物理链路上真正依次传输的 0 和 1。
这次最核心的薄弱点是:以前容易把“文件”“分组”和“bit”直接混在一起。只要这几个层次没有分开,后面的分组数、发送时延和流水线公式都会跟着混乱。
2. 不同交换方式在等待什么
| 交换方式 | 主要过程或等待单位 |
|---|---|
| 电路交换 | 先建立一条端到端的线路 |
| 报文交换 | 收到完整报文后再转发 |
| 分组交换 | 收到完整分组后再转发 |
因此,存储-转发设备等待的是一个完整分组,不是首部刚到达,也不是整个文件全部到达。
3. 发送时延和传播时延
发送时延:把长度为 L bit 的数据完整推入链路需要的时间:
d_trans = L / R传播时延:信号从链路一端跑到另一端需要的时间:
d_prop = D / V可以用两个问题区分它们:
L / R:把这串数据完整推出链路入口,需要多久?D / V:信号从链路一端跑到另一端,需要多久?
数据越大,主要影响发送时延;链路距离越长,主要影响传播时延。题目没有给出某种时延,就不要凭直觉额外添加一项“接收时延”。接收端陆续收到 bit 的过程,已经包含在发送与传播的时间关系中。
4. 单位换算必须先做
1 B = 8 bit1 Mbps = 10^6 bit/s1 s = 1000 ms特别注意大小写:b 通常表示 bit,B 表示 Byte;Mb 是兆比特,MB 是兆字节,二者相差 8 倍。
例如:
1000B = 8000bit100Mbps = 100 × 10^6bit/s5. 分组数量和完整分组长度不是一回事
这是三道题反复出现的区别:
- 求分组数量时,看每个分组能装多少有效数据;
- 求发送时延时,看完整分组有多长,首部也要算进去。
在 2010 年题 34 中:
有效数据:1000B - 20B = 980B完整分组:1000B = 8000bit在 1-11 中:
有效数据:p bit完整分组:p + h bit6. 存储-转发为什么会出现流水线
错误模型是:
分组 1 到终点 → 分组 2 开始正确模型是:
链路 1:分组1 分组2 分组3链路 2: 分组1 分组2链路 3: 分组1不同分组可以同时占用不同链路,所以总时间是:
(分组数 + 链路数 - 1) × 一个分组的一次发送时延也就是 N + K - 1,而不是 N × K。
7. 这次暴露出的个人薄弱点
| 知识点 | 当前状态 | 后续练习 |
|---|---|---|
发送时延 L/R | 已基本理解 | 继续练单位统一 |
传播时延 D/V | 已基本理解 | 和发送时延放在同一时间轴比较 |
| B/bit 转换 | 需要强化 | 单独做单位换算题 |
| 分组概念 | 刚建立 | 反复画“文件→分组→帧→bit” |
| 存储-转发 | 基本理解 | 练不同链路数 |
| 流水线 | 理解中 | 重点区分 N+K-1 与 N×K |
| 三种交换方式 | 需要重新整理 | 用“交换单位”做对照 |
| 首部开销 | 已理解 | 和分组数量一起分析 |
| 最优分组长度 | 能理解推导 | 练从总时延式中找变量项 |
这些问题的共同根源不是“不会移项”,而是还需要先把题目翻译成一张时间图:数据是什么、被切成什么、每一跳在等什么、哪些时间是公共的、哪些时间才是交换方式带来的额外开销。
8. 做题时的固定检查清单
- 题目中的数据量到底是 B 还是 bit?
- 速率是否已经统一成 bit/s?
- 分组数量使用的是有效数据长度,还是完整分组长度?
- 求发送时延时,首部是否已经算进完整分组长度?
- 路径上是几条链路,而不是几个交换机?
- 题目是否采用存储-转发,是否允许流水线?
- 传播时延、排队时延、处理时延是否真的给出?没有给出就不要擅自添加。
- 最后把结果从秒换成题目要求的毫秒,并检查数量级。
结语:先建立画面,再使用公式
这三道题暴露的主要问题不是“不会计算”,而是还没有完全建立这张图:
文件 ↓ 切分分组 ↓ 封装帧 ↓ 串行发送bit ↓ 经过多条链路发送时延 + 传播时延 + 存储-转发流水线当这张图稳定下来,公式就不再是孤立的符号:L/R 表示把数据推出去,D/V 表示信号跑过去,N+K-1 表示分组在链路之间形成流水线,√[xh/(k-1)] 则表示首部浪费和流水线等待之间的平衡。
分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
最后更新于 ,距今已过 5 天
部分内容可能已过时
评论